Un estudio del grupo Hazy Research de Stanford revela que la eficiencia de la inteligencia artificial local se multiplicó por 18 entre mediados de 2024 y finales de 2025, gracias a avances simultáneos en arquitectura de modelos y hardware especializado. El hallazgo introduce nuevas métricas de medición y proyecta ahorros de hasta 80% en costos de inferencia mediante estrategias híbridas local-nube.
¿Cuánto mejoró la eficiencia de la IA local en los últimos 16 meses?
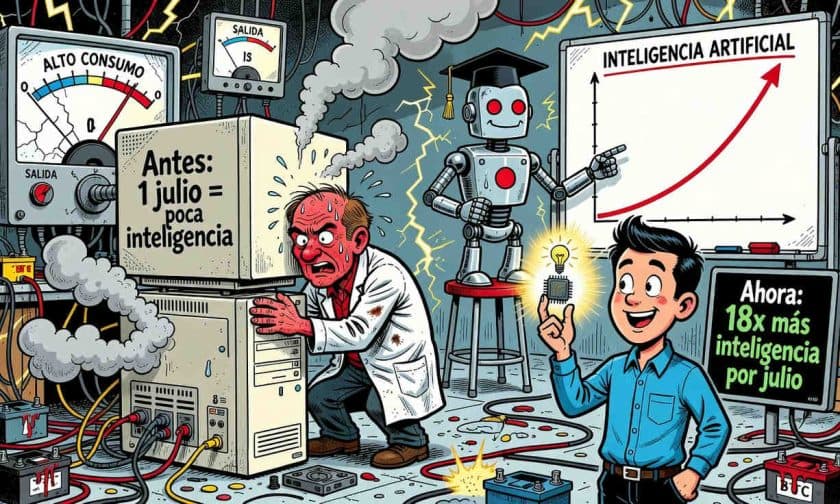
La eficiencia de la inteligencia artificial local se multiplicó por 18 veces entre mediados de 2024 y finales de 2025, según la investigación presentada por Hazy Research en el artículo "Measuring Intelligence Efficiency of Local AI". Este avance sin precedentes no proviene de una única innovación, sino de la combinación sinérgica de mejoras en dos frentes simultáneamente: el diseño de los modelos y la capacidad del hardware que los ejecuta.
Para cuantificar este progreso, los investigadores de Stanford introdujeron dos métricas clave: Inteligencia por Julio (IPJ) e Inteligencia por Vatio (IPW). La primera mide cuánta inteligencia útil genera un modelo por cada julio de energía consumida, funcionando como el equivalente a "millas por galón" para sistemas de IA que corren en hardware propio. La segunda refleja el desempeño sostenido durante operaciones continuas, crucial para aplicaciones que requieren funcionamiento constante.
Cómo se distribuye el salto de 18x: arquitectura y hardware
El estudio desglosa el origen del progreso en dos componentes diferenciados. Las optimizaciones en arquitectura de modelos aportaron 3,1 veces de la mejora total, mientras que los avances en hardware y aceleradores contribuyeron con 5,9 veces. Multiplicados en conjunto, estos factores alcanzan el salto de 18x que documenta la investigación.
En el lado de las arquitecturas, los investigadores rastrearon la evolución desde modelos como Mixtral-8x7B hacia diseños más recientes de mezcla de expertos. Estos sistemas enrutan el cálculo de manera selectiva, activando solo los parámetros necesarios para cada consulta en lugar de procesar toda la red, lo que reduce drásticamente el consumo energético. Respecto al hardware, el análisis comparó desde la GPU NVIDIA Quadro RTX 6000 hasta aceleradores de última generación como NVIDIA B200 y SambaNova SN40L, que superaron ampliamente al silicio de consumo general en eficiencia.
Los modelos locales evaluados alcanzaron aproximadamente 88,7% de precisión en tareas conversacionales y de razonamiento de un solo turno, demostrando que la inferencia local es viable para una amplia gama de aplicaciones empresariales. Además, durante 2025 la métrica IPW mostró un aumento de 5,3 veces en dos años, confirmando que las mejoras en eficiencia energética son una tendencia de largo plazo.
Estrategia híbrida local-nube: reducción de costos hasta 80%
Uno de los hallazgos con mayor impacto práctico es el potencial del enrutamiento híbrido. Manejar las consultas simples en el dispositivo local y enviar solo las consultas complejas a la nube puede reducir el consumo de energía, los requisitos de cómputo y los costos operativos entre 60% y 80% sin sacrificios significativos en calidad.
Para ilustrar el impacto económico, los investigadores del grupo Hazy Research proyectaron un escenario concreto: si una empresa gasta US$ 10.000.000,00 anuales en inferencia de IA en la nube, un enfoque híbrido bien implementado podría reducir esa cifra a entre US$ 2.000.000,00 y US$ 4.000.000,00, manteniendo resultados comparables. Esta proyección se basa en que las consultas simples suelen representar la mayoría del tráfico, y procesarlas localmente con modelos eficientes disminuye la carga de los servicios en la nube.
Herramientas y disponibilidad para empresas
El estudio publicó un banco de pruebas de perfilado alrededor de noviembre de 2025, brindando a los equipos técnicos una herramienta concreta para evaluar sus propias configuraciones frente a estos nuevos estándares de eficiencia. Las empresas pueden ahora medir sus implementaciones de IA y compararlas con los rendimientos energéticos documentados por Stanford, facilitando decisiones de inversión en hardware y arquitectura.
Impacto para empresas y administradores argentinos
Para los dueños y administradores de empresas en Argentina, estos hallazgos de Stanford abren una oportunidad estratégica significativa. Las organizaciones que actualmente dependen exclusivamente de servicios en la nube para procesamiento de inteligencia artificial deberían evaluar la implementación de modelos locales e infraestructura híbrida como una alternativa de reducción de costos operativos.
En contextos de volatilidad económica como el argentino, donde los gastos en dólares para servicios en la nube impactan directamente en márgenes empresariales, la posibilidad de reducir facturas anuales en millones de dólares manteniendo calidad de respuesta es un incentivo poderoso. Las pymes que procesan datos sensibles o requieren procesamiento de lenguaje natural (atención al cliente, automatización de procesos, análisis de información) pueden evaluar migrar consultas simples a hardware local, reservando la nube solo para operaciones complejas que justifiquen el costo. La publicación del banco de pruebas permite a equipos técnicos locales validar estas arquitecturas antes de invertir en infraestructura nueva.