Los agentes de inteligencia artificial procesan un volumen de tokens significativamente superior al del uso humano en OpenRouter, según datos de agosto de 2026, lo que plantea desafíos crecientes sobre la capacidad de memoria de los centros de datos.
¿Cuántos tokens consumen los agentes de IA frente a los usuarios?
Al 10 de agosto de 2026, los agentes de IA registraban 7,3 billones de tokens en OpenRouter, en contraste con 1,4 billones de tokens atribuidos a usuarios humanos. Esa proporción de más de cinco a uno refleja un cambio estructural en cómo se utiliza la infraestructura de modelos de lenguaje. La plataforma OpenRouter, que funciona como intermediaria de acceso a distintos modelos de IA, ofrece visibilidad sobre patrones de consumo que hace apenas meses mostraban una realidad inversa.
El cruce entre ambas categorías ocurrió en febrero de 2026. Desde ese punto, el consumo de agentes se multiplicó por 14, mientras que el uso humano creció 2,8 veces. Esa divergencia acelera y plantea interrogantes sobre la sostenibilidad del modelo actual de infraestructura. Daniel Newman, CEO de Futurum Group, proyectó en septiembre de 2026 que la relación podría ampliarse hasta diez veces o más en los próximos meses.
El rol de los prompts en caché en el consumo de tokens
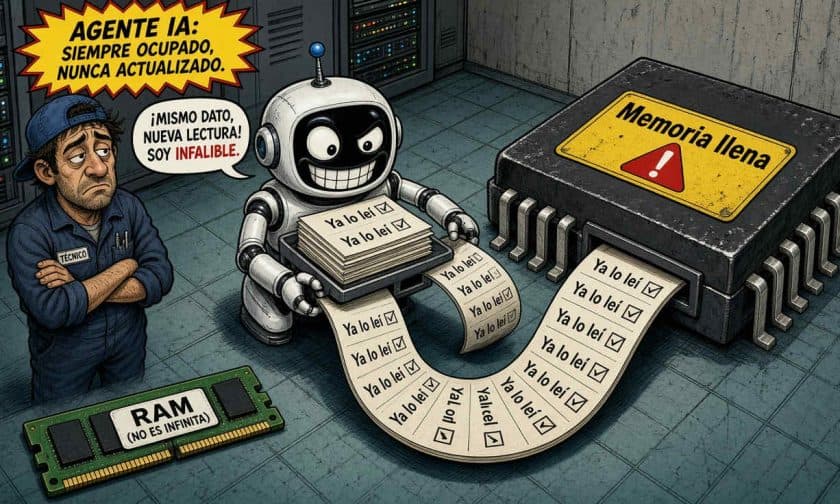
Un dato crítico para interpretar estas cifras: más del 85% de los tokens de agentes provendría de prompts en caché, según análisis de Andreessen Horowitz basado en datos de OpenRouter. Esto significa que gran parte del volumen no representa procesamiento nuevo, sino relectura de información ya calculada. Los modelos almacenan contexto en estructuras llamadas caché KV, que permiten reutilizar partes de conversaciones anteriores sin recalcular cada token desde cero.
Ese mecanismo reduce significativamente el costo de procesamiento, pero no elimina la demanda de recursos. Mantener esos datos disponibles en memoria requiere capacidad física, trasladando la presión desde el procesamiento hacia el almacenamiento. Un ejemplo concreto: una consultora de centros de llamadas que probó agentes en Claude Code observó que el 96% de toda la entrada consistía en releer conversaciones antiguas. El caso ilustra cómo la repetición de contexto puede dominar el registro de entrada de sistemas automatizados.
Memoria de alto ancho de banda: el cuello de botella real
La presión se concentra en la memoria HBM (High Bandwidth Memory), componente crítico en GPU para centros de datos. A medida que los agentes acumulan y consultan más contexto, la caché KV está superando la capacidad disponible en muchos sistemas. Esto genera un desafío que va más allá de los costos de facturación: es una limitación física de hardware.
Un prompt almacenado en caché puede costar una fracción del procesamiento completo, pero requiere espacio para que el modelo lo consulte repetidamente. Para operadores de infraestructura, la distinción es fundamental: el costo de procesar información es diferente al de mantenerla disponible. Ambos son reales, y ambos crecen con el uso de agentes.
Restricciones de oferta de memoria hasta 2028
La demanda creciente de HBM coincide con advertencias sobre restricciones de suministro. Micron proyecta que la escasez de memoria se prolongará hasta 2028 y que la oferta en 2027 y 2028 será más ajustada que en 2026. Aunque estas previsiones no cuantifican directamente cuánta presión corresponde a agentes de IA, la competencia por capacidad de fabricación puede repercutir en precios y disponibilidad para otros compradores.
Si los fabricantes destinan más recursos a HBM para infraestructura de IA, la disponibilidad de otros productos de memoria podría resentirse. Esa tensión afecta tanto a grandes centros de datos como a empresas que dependen de componentes de memoria para otras aplicaciones.
Limitaciones de la medición y variabilidad en los datos
OpenRouter clasifica cada clave de API mediante siete señales ponderadas: frecuencia de llamadas a herramientas, cantidad de turnos, tiempo entre interacciones y otras variables de comportamiento. No todos los flujos encajan de forma inequívoca en una sola categoría. El grupo de uso mixto, que combina actividad parcialmente automatizada y parcialmente humana, creció 4,7 veces en el período analizado. Si parte de ese tráfico se reasignara a agentes, la brecha observada sería aún mayor.
Además, los datos representan una sola plataforma. Aunque otros indicadores confirman el crecimiento de agentes —en la encuesta State of AI 2026 de McKinsey, el 40% de las grandes organizaciones afirmó estar escalando agentes, frente al 27% un año antes—, la magnitud varía según la métrica y el alcance de la medición.
Impacto para empresas y administradores argentinos
Para dueños y administradores de empresas en Argentina, esta tendencia global tiene implicaciones directas. Si tu negocio depende de servicios en la nube basados en IA o planea implementar agentes automatizados, los costos de infraestructura podrían presionarse tanto por el precio del procesamiento como por la escasez de memoria. Las restricciones de oferta proyectadas para 2027 y 2028 afectarán los precios de servicios cloud y la disponibilidad de recursos.
Además, la competencia por HBM podría impactar en el costo de computadoras y servidores que tu empresa utiliza para otras operaciones. Aunque el consumo de agentes de IA crece exponencialmente, la capacidad industrial de memoria es limitada. Monitorear estas dinámicas es esencial para planificar inversiones en tecnología y evaluar cuándo es rentable adoptar soluciones basadas en agentes automatizados frente a alternativas tradicionales.